Aller au contenu principal

Espaces probabilisés

Expériences aléatoires​

En probabilité, le point de départ est ce qu'on appelle habituellement une expérience aléatoire (ou épreuve). Une telle expérience aléatoire E\mathcal{E} est caractérisée par :

  • un espace des résultats possibles Ω\Omega ;
  • un ensemble d'événements F\mathcal{F} (partie de Ω\Omega, sous-ensemble de Ω\Omega) qui doit vérifier les propriétés d'une tribu ;
  • la donnée d'une probabilité sur Ω\Omega (application de F→[0,1]\mathcal{F} \to [0, 1] qui doit vérifier 2 axiomes).

3 exemples d'expériences aléatoires.

  1. E1\mathcal{E}_1 : on lance un dé équilibré.
  2. E2\mathcal{E}_2 : on lance une pièce qui a une probabilité p>0p > 0 de retomber sur face jusqu'à obtenir le premier face.
  3. E3\mathcal{E}_3 : un générateur de nombres aléatoires renvoie un nombre réel compris entre 0 et 1 (exemple de ALEA() dans un tableur).

L'espace des résultats possibles​

Définition. L'ensemble des résultats possibles d'une expérience aléatoire est appelé ensemble des événements élémentaires ou encore univers des possibles. On le note généralement Ω\Omega.

  1. E1\mathcal{E}_1 : Ω1={1,2,3,4,5,6}\Omega_1 = \lbrace 1, 2, 3, 4, 5, 6 \rbrace, Ω1\Omega_1 est un ensemble fini, card(Ω1)=#Ω1=6card(\Omega_1) = \#\Omega_1 = 6.
  2. E2\mathcal{E}_2 : Ω2={(F),(P,F),(P,P,F),…,(P,…,P,F),… }∪{(P,…,P,… )}\Omega_2 = \lbrace (F), (P, F), (P, P, F), \dots, (P, \dots, P, F), \dots \rbrace \cup \lbrace (P, \dots, P, \dots) \rbrace.
  3. E3\mathcal{E}_3 : Ω3=[0,1]\Omega_3 = [0, 1].

Les ensembles Ω2\Omega_2 et Ω3\Omega_3 sont tous les 2 infinis, mais Ω2\Omega_2 est dénombrable alors que [0,1][0, 1] ne l'est pas.

Ensembles dénombrables​

Historiquement, il existe deux définitions de la notion d'ensemble dénombrable.

Définition 1. On dit qu'un ensemble EE est dénombrable s'il est en bijection avec N\mathbb{N} (on dit aussi que EE est équipotent à N\mathbb{N}). C'est la définition originale de Georg Cantor.

Définition 2. On dit que EE est dénombrable s'il est en bijection avec une partie de N\mathbb{N}. Avec cette définition, les ensembles finis sont dénombrables. On parlera alors d'ensemble infini dénombrable pour le cas d'un ensemble infini.

Si on retient la définition 1, les ensembles dénombrables sont toujours infinis. Pour regrouper les notions d'ensemble fini et d'ensemble dénombrable, on parle d'ensemble au plus dénombrable ; dans ce cours, on utilisera la définition 1.

Remarque. En probabilité, on dit aussi parfois qu'un ensemble fini ou dénombrable est un ensemble discret (probabilité discrète). Mais cela ne correspond pas à la « vraie » définition d'un ensemble discret. On dit qu'un sous-ensemble D⊂RD \subset \mathbb{R} est discret si pour tout x∈Dx \in D, ∃ε>0\exists \varepsilon > 0 tel que ]x−ε,x+ε[∩D={x}]x - \varepsilon, x + \varepsilon[ \cap D = \lbrace x \rbrace.

Propriété. On peut montrer qu'un sous-ensemble de R\mathbb{R} discret est fini ou dénombrable, mais la réciproque est clairement fausse. Soit E={1n,n≥1}∪{0}E = \left\lbrace \dfrac{1}{n}, n \geq 1 \right\rbrace \cup \lbrace 0 \rbrace. EE est dénombrable (évident) mais EE n'est pas discret au sens de la définition précédente. En effet, on ne peut trouver ε>0\varepsilon > 0 tel que ]−ε,ε[∩E={0}]-\varepsilon, \varepsilon[ \cap E = \lbrace 0 \rbrace (0 est ce que l'on appelle un point d'accumulation).

Exemples d'ensembles dénombrables​

  1. N∗\mathbb{N}^* est dénombrable.

    Démonstration. On considère

    f:{N→N∗n↦f(n)=n+1f : \begin{cases} \mathbb{N} \to \mathbb{N}^* \\ n \mapsto f(n) = n + 1 \end{cases}
  2. Z\mathbb{Z} est dénombrable.

    Démonstration. On peut écrire Z={0,−1,1,−2,2,… }\mathbb{Z} = \lbrace 0, -1, 1, -2, 2, \dots \rbrace. On considère

    f:{N→Zn↦f(n)={n/2si n pair−n+12si n impairf : \begin{cases} \mathbb{N} \to \mathbb{Z} \\ n \mapsto f(n) = \begin{cases} n/2 & \text{si } n \text{ pair} \\ -\dfrac{n + 1}{2} & \text{si } n \text{ impair} \end{cases} \end{cases}

    On peut aussi écrire f(n)=(−1)nE(n+12)f(n) = (-1)^n E\left(\dfrac{n + 1}{2}\right).

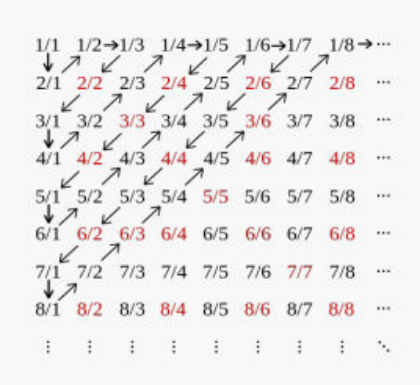
  3. N2\mathbb{N}^2 est dénombrable.

    Énumération des fractions p/q par parcours en diagonale du tableau

    Π(0,0)=0,Π(1,0)=1,Π(0,1)=2,Π(0,2)=3,Π(1,1)=4…\Pi(0, 0) = 0, \Pi(1, 0) = 1, \Pi(0, 1) = 2, \Pi(0, 2) = 3, \Pi(1, 1) = 4 \dots définit une bijection de N2→N\mathbb{N}^2 \to \mathbb{N}.

    On peut aussi remarquer que la fonction ϕ(k,l)=2k(2l+1)\phi(k, l) = 2^k(2l + 1) définit une bijection de N2→N∗\mathbb{N}^2 \to \mathbb{N}^*.

On voit bien qu'intuitivement, on peut dire qu'un ensemble EE est dénombrable si on peut numéroter de façon exhaustive tous ses éléments, autrement dit si on peut représenter les éléments de EE sous la forme d'une suite, ou encore si on peut « compter » EE (countable set).

Définitions. Si EE est un ensemble dénombrable et si ϕ:N→E\phi : \mathbb{N} \to E est une bijection, on dit que la suite ϕ(0),ϕ(1),…,ϕ(n),…\phi(0), \phi(1), \dots, \phi(n), \dots est une énumération de EE.

Propriétés des ensembles dénombrables​

Théorème I.1. Toute partie infinie de N\mathbb{N} est dénombrable.

Théorème I.2. Un ensemble est fini ou dénombrable si et seulement s'il est en bijection avec une partie de N\mathbb{N}.

Théorème I.3. Toute partie d'un ensemble dénombrable est au plus dénombrable.

Corollaire 1. S'il existe une injection d'un ensemble EE dans un ensemble dénombrable, alors EE est au plus dénombrable.

Produit cartésien d'ensembles dénombrables​

Théorème I.4. Si EE et FF sont des ensembles dénombrables, alors E×FE \times F est dénombrable.

Corollaire 2. Si E1,…,EnE_1, \dots, E_n sont des ensembles dénombrables, alors E1×⋯×EnE_1 \times \dots \times E_n est dénombrable.

Exemple. Q+∗\mathbb{Q}^*_+ est dénombrable. Soit ϕ:pq→(p,q)\phi : \dfrac{p}{q} \to (p, q) où pq\dfrac{p}{q} est irréductible. On voit bien que ϕ\phi est injective de Q+∗\mathbb{Q}^*_+ dans N×N\mathbb{N} \times \mathbb{N} (c'est-à-dire si ss et s′s' sont deux rationnels positifs, ϕ(s)=ϕ(s′)⇒s=s′\phi(s) = \phi(s') \Rightarrow s = s'). Or N×N\mathbb{N} \times \mathbb{N} est dénombrable, donc Q+∗\mathbb{Q}^*_+ est dénombrable par le corollaire 1.

Théorème I.5. (Réunion) Soit (Ei)i∈I(E_i)_{i \in I} une famille d'ensembles dénombrables. Si ∀i\forall i, EiE_i est au plus dénombrable et si II est également dénombrable, alors ⋃i∈IEi\bigcup_{i \in I} E_i est au plus dénombrable.

Un exemple d'ensemble non dénombrable. Soit E⊂R+E \subset \mathbb{R}_+ l'ensemble des nombres s'écrivant sous la forme

x=∑i=1+∞εi10i,ouˋ εi∈{0,1}x = \sum_{i=1}^{+\infty} \frac{\varepsilon_i}{10^i}, \quad \text{où } \varepsilon_i \in \lbrace 0, 1 \rbrace

Exemple : x=0,01001110…x = 0{,}01001110\dots Supposons que EE est dénombrable. Alors on peut trouver une bijection de N∗→E\mathbb{N}^* \to E :

f(1)=0,ε11ε21…εn1…f(2)=0,ε12ε22…εn2…  ⋮f(n)=0,ε1nε2n…εnn…\begin{aligned} f(1) &= 0{,}\varepsilon^1_1 \varepsilon^1_2 \dots \varepsilon^1_n \dots \\ f(2) &= 0{,}\varepsilon^2_1 \varepsilon^2_2 \dots \varepsilon^2_n \dots \\ &\ \ \vdots \\ f(n) &= 0{,}\varepsilon^n_1 \varepsilon^n_2 \dots \varepsilon^n_n \dots \end{aligned}

(énumère tout l'ensemble EE). Soit alors x=0,ε1′ε2′…εn′…x = 0{,}\varepsilon'_1 \varepsilon'_2 \dots \varepsilon'_n \dots avec ∀i≥1\forall i \geq 1, εi′=1−εii\varepsilon'_i = 1 - \varepsilon^i_i (∀n≥1\forall n \geq 1, εn′=1−εnn\varepsilon'_n = 1 - \varepsilon^n_n). Alors on voit qu'on ne peut pas avoir x=f(n)x = f(n) pour n∈N∗n \in \mathbb{N}^*. Donc EE n'est pas dénombrable. Donc {0,1}N\lbrace 0, 1 \rbrace^{\mathbb{N}}, ou encore [0,1][0, 1], ou bien R\mathbb{R}, ne sont pas dénombrables.

Tribus​

Définition. Soit un espace Ω\Omega. On dit qu'un ensemble F\mathcal{F} de parties (sous-ensembles) de Ω\Omega est une tribu si :

  1. Ω∈F\Omega \in \mathcal{F} ;
  2. A∈F⇒Ac∈FA \in \mathcal{F} \Rightarrow A^c \in \mathcal{F} (stabilité par passage au complémentaire) ;
  3. pour toute suite (An)n≥1(A_n)_{n \geq 1} d'éléments de F\mathcal{F}, ⋃n=1+∞An∈F\displaystyle\bigcup_{n=1}^{+\infty} A_n \in \mathcal{F} (stabilité par réunion dénombrable).

Définitions. On appelle ensemble des parties de Ω\Omega l'ensemble de tous les sous-ensembles de Ω\Omega, y compris ∅\emptyset et Ω\Omega lui-même. On le note P(Ω)\mathcal{P}(\Omega).

Remarque. P(Ω)\mathcal{P}(\Omega) est une tribu sur Ω\Omega (c'est la plus grande), F={∅,Ω}\mathcal{F} = \lbrace \emptyset, \Omega \rbrace est une tribu (c'est la plus petite).

Définition. Soit un espace Ω\Omega muni d'une tribu F\mathcal{F} (espace « probabilisable »). On appelle événement tout élément de F\mathcal{F}, c'est-à-dire toute partie de Ω\Omega appartenant à F\mathcal{F}.

Remarque. En pratique, quand Ω\Omega est au plus dénombrable, on verra qu'on peut définir une probabilité pour toute partie de Ω\Omega, et on pourra donc prendre F=P(Ω)\mathcal{F} = \mathcal{P}(\Omega).

Exemples de tribus. Soit Ω={a,b,c}\Omega = \lbrace a, b, c \rbrace.

F1={∅,{a},{b,c},Ω}\mathcal{F}_1 = \lbrace \emptyset, \lbrace a \rbrace, \lbrace b, c \rbrace, \Omega \rbrace, F2={∅,{b},{a,c},Ω}\mathcal{F}_2 = \lbrace \emptyset, \lbrace b \rbrace, \lbrace a, c \rbrace, \Omega \rbrace.

Plus généralement, ∀A⊂Ω\forall A \subset \Omega, F={∅,A,Ac,Ω}\mathcal{F} = \lbrace \emptyset, A, A^c, \Omega \rbrace est une tribu. G={∅,{a},{b},Ω}\mathcal{G} = \lbrace \emptyset, \lbrace a \rbrace, \lbrace b \rbrace, \Omega \rbrace n'est pas une tribu.

Tribu borélienne. Soit Ω=R\Omega = \mathbb{R} et M={]−∞,t],t∈R}\mathcal{M} = \lbrace ]-\infty, t], t \in \mathbb{R} \rbrace. La plus petite tribu contenant M\mathcal{M} est appelée tribu borélienne sur R\mathbb{R} et on la note B(R)\mathcal{B}(\mathbb{R}). Les éléments de B(R)\mathcal{B}(\mathbb{R}) sont appelés « boréliens ».

Propriétés élémentaires. Soit F\mathcal{F} une tribu.

  1. ∅∈F\emptyset \in \mathcal{F} (car ∅=Ωc\emptyset = \Omega^c).

  2. Soit (An)n≥1(A_n)_{n \geq 1} une suite d'éléments de F\mathcal{F}. Alors ⋂n=1∞An∈F\displaystyle\bigcap_{n=1}^{\infty} A_n \in \mathcal{F} (stabilité par intersection dénombrable).

    Démonstration. ⋂n=1∞An=(⋃n=1∞Anc)c\displaystyle\bigcap_{n=1}^{\infty} A_n = \left(\bigcup_{n=1}^{\infty} A_n^c\right)^c.

  3. Soit AA et BB dans F\mathcal{F}. Alors A∖B=A∩Bc∈FA \setminus B = A \cap B^c \in \mathcal{F} (car A∩Bc=A∩Bc∩Ω∩Ω∩⋯∩Ω…A \cap B^c = A \cap B^c \cap \Omega \cap \Omega \cap \dots \cap \Omega \dots).

Probabilité​

Définition. Soit Ω\Omega un espace muni d'une tribu d'événements F\mathcal{F}. On appelle probabilité sur (Ω,F)(\Omega, \mathcal{F}) toute application

P:{F→[0,1]A∈F↦P(A)P : \begin{cases} \mathcal{F} \to [0, 1] \\ A \in \mathcal{F} \mapsto P(A) \end{cases}

vérifiant les axiomes suivants :

  1. P(Ω)=1P(\Omega) = 1 ;
  2. soit (Ai)i≥1(A_i)_{i \geq 1} une suite d'événements tels que Ai∩Aj=∅A_i \cap A_j = \emptyset, ∀i≠j\forall i \neq j (on parle d'événements 2 à 2 disjoints), alors P(⋃i=1∞Ai)=∑i=1∞P(Ai)P\left(\displaystyle\bigcup_{i=1}^{\infty} A_i\right) = \displaystyle\sum_{i=1}^{\infty} P(A_i) (propriété de σ\sigma-additivité).

Définition. Le triplet (Ω,F,P)(\Omega, \mathcal{F}, P) est appelé espace probabilisé.

Première conséquence. Probabilité sur un espace au plus dénombrable. Dans le cas Ω={ω1,…,ωn,… }\Omega = \lbrace \omega_1, \dots, \omega_n, \dots \rbrace, on peut définir une probabilité sur (Ω,P(Ω))(\Omega, \mathcal{P}(\Omega)) en définissant les valeurs de P(ωi)P(\omega_i), ∀i\forall i. En effet, soit A∈P(Ω)A \in \mathcal{P}(\Omega), alors on peut toujours écrire

A=⋃{i,ωi∈A}{ωi}A = \bigcup_{\lbrace i, \omega_i \in A \rbrace} \lbrace \omega_i \rbrace

Or {ωi}∩{ωj}=∅\lbrace \omega_i \rbrace \cap \lbrace \omega_j \rbrace = \emptyset ∀i≠j\forall i \neq j, donc d'après l'axiome 2

P(A)=∑i,ωi∈AP(ωi)P(A) = \sum_{i, \omega_i \in A} P(\omega_i)

Dans le cas où Ω\Omega est fini ou dénombrable, il est donc naturel de poser F=P(Ω)\mathcal{F} = \mathcal{P}(\Omega).

Exemples de probabilités.

  1. E1\mathcal{E}_1 : P(1)=1/6,…,P(6)=1/6P(1) = 1/6, \dots, P(6) = 1/6.

  2. E2\mathcal{E}_2 : P2(F)=pP_2(F) = p, P2((P,F))=(1−p)×pP_2((P, F)) = (1 - p) \times p, P2((P,…,P,F))=(1−p)n−1×pP_2((P, \dots, P, F)) = (1 - p)^{n-1} \times p, P2((P,…,P,… ))=0P_2((P, \dots, P, \dots)) = 0.

  3. Pour l'expérience E3\mathcal{E}_3 (génération de nombres aléatoires), Ω3=[0,1]\Omega_3 = [0, 1] n'est pas dénombrable. On pose F=B(R)∣[0,1]={A∩[0,1],A∈B(R)}\mathcal{F} = \mathcal{B}(\mathbb{R})_{|[0,1]} = \lbrace A \cap [0, 1], A \in \mathcal{B}(\mathbb{R}) \rbrace. On peut montrer qu'il existe une (unique) probabilité PP sur (Ω3,F3)(\Omega_3, \mathcal{F}_3) vérifiant

    ∀(a,b)∈[0,1]×[0,1],P([a,b])=b−a(loi uniforme)\forall (a, b) \in [0, 1] \times [0, 1], \quad P([a, b]) = b - a \qquad \text{(loi uniforme)}

    On voit bien dans ce cas que ∀x∈[0,1]\forall x \in [0, 1], P(X=x)=0P(X = x) = 0 (voir preuve plus tard) et qu'on ne peut définir PP par la donnée de P(X=x)P(X = x), x∈Ωx \in \Omega.

Remarque. XX est une variable aléatoire de loi uniforme sur [0,1][0, 1]. La densité est la fonction

f(x)=1[0,1](x)={1si x∈[0,1]0sinonf(x) = \mathbb{1}_{[0,1]}(x) = \begin{cases} 1 & \text{si } x \in [0, 1] \\ 0 & \text{sinon} \end{cases}

Propriétés des probabilités​

  1. (a) P(∅)=0P(\emptyset) = 0.

    Démonstration. ∅∪Ω=Ω\emptyset \cup \Omega = \Omega et ∅∩Ω=∅\emptyset \cap \Omega = \emptyset, donc P(Ω)+P(∅)=P(Ω)P(\Omega) + P(\emptyset) = P(\Omega), donc P(∅)=0P(\emptyset) = 0.

    (b) P(Ac)=1−P(A)P(A^c) = 1 - P(A).

    Démonstration. A∪Ac=ΩA \cup A^c = \Omega et A∩Ac=∅A \cap A^c = \emptyset, donc P(A)+P(Ac)=P(Ω)⇒P(Ac)=P(Ω)−P(A)=1−P(A)P(A) + P(A^c) = P(\Omega) \Rightarrow P(A^c) = P(\Omega) - P(A) = 1 - P(A).

  2. Soit A1,…,AnA_1, \dots, A_n nn événements 2 à 2 disjoints. Alors P(⋃i=1nAi)=∑i=1nP(Ai)P\left(\displaystyle\bigcup_{i=1}^{n} A_i\right) = \displaystyle\sum_{i=1}^{n} P(A_i) (car A1∪⋯∪An=A1∪⋯∪An∪∅∪⋯∪∅…A_1 \cup \dots \cup A_n = A_1 \cup \dots \cup A_n \cup \emptyset \cup \dots \cup \emptyset \dots).

  3. P(A∪B)=P(A)+P(B∖A)P(A \cup B) = P(A) + P(B \setminus A).

    Démonstration. A∪(B∖A)=A∪(B∩Ac)=(A∪B)∩(A∪Ac)⏟=Ω=A∪BA \cup (B \setminus A) = A \cup (B \cap A^c) = (A \cup B) \cap \underbrace{(A \cup A^c)}_{= \Omega} = A \cup B et A∩(B∖A)=A∩B∩Ac=∅A \cap (B \setminus A) = A \cap B \cap A^c = \emptyset.

  4. Si A⊂BA \subset B, alors P(B∖A)=P(B)−P(A)P(B \setminus A) = P(B) - P(A) (et donc P(A)≤P(B)P(A) \leq P(B)).

  5. P(B∖A)=P(B)−P(A∩B)P(B \setminus A) = P(B) - P(A \cap B).

    Démonstration.

    B∖A=B∩Ac=(B∩Ac)∪(B∩Bc)=B∩(Ac∪Bc)=B∩(A∩B)c=B∖(A∩B)\begin{aligned} B \setminus A &= B \cap A^c \\ &= (B \cap A^c) \cup (B \cap B^c) \\ &= B \cap (A^c \cup B^c) \\ &= B \cap (A \cap B)^c \\ &= B \setminus (A \cap B) \end{aligned}

    Or A∩B⊂BA \cap B \subset B, d'où P(B∖A)=P(B∖(A∩B))=par 4P(B)−P(A∩B)P(B \setminus A) = P(B \setminus (A \cap B)) \underset{\text{par } 4}{=} P(B) - P(A \cap B).

  6. Donc P(A∪B)=P(A)+P(B∖A)=P(A)+P(B)−P(A∩B)P(A \cup B) = P(A) + P(B \setminus A) = P(A) + P(B) - P(A \cap B).

  7. Sous-additivité.

    P(⋃n=1∞An)≤∑n=1∞P(An)P\left(\bigcup_{n=1}^{\infty} A_n\right) \leq \sum_{n=1}^{\infty} P(A_n)

    Démonstration. Si on pose B1=A1B_1 = A_1, ∀n≥2\forall n \geq 2, Bn=An∖(A1∪A2∪⋯∪An−1)B_n = A_n \setminus (A_1 \cup A_2 \cup \dots \cup A_{n-1}). On a ⋃n=1∞An=⋃n=1∞Bn\displaystyle\bigcup_{n=1}^{\infty} A_n = \bigcup_{n=1}^{\infty} B_n et les événements (Bn)n≥1(B_n)_{n \geq 1} sont deux à deux disjoints. D'autre part, ∀n\forall n, Bn⊂AnB_n \subset A_n, donc

    P(⋃n=1∞An)=P(⋃n=1∞Bn)=∑n=1∞P(Bn)≤∑n=1∞P(An)P\left(\bigcup_{n=1}^{\infty} A_n\right) = P\left(\bigcup_{n=1}^{\infty} B_n\right) = \sum_{n=1}^{\infty} P(B_n) \leq \sum_{n=1}^{\infty} P(A_n)
  8. Monotonie.

    (a) Soit (An)n≥1(A_n)_{n \geq 1} avec An⊂An+1A_n \subset A_{n+1}. Alors

    P(⋃n=1∞An)=lim⁡n→+∞P(An)P\left(\bigcup_{n=1}^{\infty} A_n\right) = \lim_{n \to +\infty} P(A_n)

    Démonstration. Soit Bn=An∖(A1∪⋯∪An−1)B_n = A_n \setminus (A_1 \cup \dots \cup A_{n-1}) ; on a An=A1∪⋯∪An=B1∪⋯∪BnA_n = A_1 \cup \dots \cup A_n = B_1 \cup \dots \cup B_n, ∀n\forall n, et ⋃n=1∞An=⋃n=1∞Bn\displaystyle\bigcup_{n=1}^{\infty} A_n = \bigcup_{n=1}^{\infty} B_n. Donc

    P(⋃n=1∞An)=P(⋃n=1∞Bn)=∑n=1∞P(Bn)=lim⁡n→+∞∑i=1nP(Bi)=lim⁡n→+∞P(⋃i=1nBi)=lim⁡n→+∞P(B1∪⋯∪Bn)=lim⁡n→+∞P(An)\begin{aligned} P\left(\bigcup_{n=1}^{\infty} A_n\right) &= P\left(\bigcup_{n=1}^{\infty} B_n\right) \\ &= \sum_{n=1}^{\infty} P(B_n) \\ &= \lim_{n \to +\infty} \sum_{i=1}^{n} P(B_i) \\ &= \lim_{n \to +\infty} P\left(\bigcup_{i=1}^{n} B_i\right) \\ &= \lim_{n \to +\infty} P(B_1 \cup \dots \cup B_n) \\ &= \lim_{n \to +\infty} P(A_n) \end{aligned}

    (b) Soit (An)n≥1(A_n)_{n \geq 1} avec An+1⊂AnA_{n+1} \subset A_n. Alors

    P(⋂n=1∞An)=lim⁡n→+∞P(An)P\left(\bigcap_{n=1}^{\infty} A_n\right) = \lim_{n \to +\infty} P(A_n)

    Démonstration. Anc⊂An+1cA_n^c \subset A_{n+1}^c (suite croissante), P(An)+P(Anc)=1P(A_n) + P(A_n^c) = 1. D'après 8.a,

    P(Anc)→P(⋃n=1∞Anc)⇔1−P(An)→1−P(⋂n=1∞An)⇔P(An)→P(⋂n=1∞An)P(A_n^c) \to P\left(\bigcup_{n=1}^{\infty} A_n^c\right) \Leftrightarrow 1 - P(A_n) \to 1 - P\left(\bigcap_{n=1}^{\infty} A_n\right) \Leftrightarrow P(A_n) \to P\left(\bigcap_{n=1}^{\infty} A_n\right)

On peut utiliser 8.b pour montrer que, dans le cas de la probabilité sur [0,1][0, 1] donnée en exemple, on a bien P({x})=P([x,x])=0P(\lbrace x \rbrace) = P([x, x]) = 0, ∀x∈]0,1[\forall x \in ]0, 1[ ; on peut écrire {x}=⋂n=1∞[x−1n,x+1n]\lbrace x \rbrace = \displaystyle\bigcap_{n=1}^{\infty} \left[x - \frac{1}{n}, x + \frac{1}{n}\right]

⇒P({x})=lim⁡n→+∞P([x−1n,x+1n])=lim⁡n→+∞2n=0\Rightarrow P(\lbrace x \rbrace) = \lim_{n \to +\infty} P\left(\left[x - \frac{1}{n}, x + \frac{1}{n}\right]\right) = \lim_{n \to +\infty} \frac{2}{n} = 0

Autre application. Expérience E2\mathcal{E}_2 (on lance une pièce jusqu'à obtenir face).

P((P,…,P))=(probabiliteˊ de ne jamais obtenir face)P((P, \dots, P)) = (\text{probabilité de ne jamais obtenir face})

On a (P,…,P,… )=⋂n≥1An(P, \dots, P, \dots) = \displaystyle\bigcap_{n \geq 1} A_n avec An=(P,…,P)A_n = (P, \dots, P) = on obtient pile nn fois de suite. On voit que An+1⊂AnA_{n+1} \subset A_n. D'où, d'après 8.b,

P((P,…,P,… ))=lim⁡n→+∞P(An)=lim⁡n→+∞(1−p)n=0(p>0)\begin{aligned} P((P, \dots, P, \dots)) &= \lim_{n \to +\infty} P(A_n) \\ &= \lim_{n \to +\infty} (1 - p)^n \\ &= 0 \quad (p > 0) \end{aligned}

Indépendance et conditionnement​

Intuitivement, 2 événements seront dits indépendants si la réalisation de l'un ne modifie pas la probabilité de l'autre.

Définition. On dit que deux événements AA et BB sont indépendants pour la probabilité PP si

P(A∩B)=P(A)×P(B)P(A \cap B) = P(A) \times P(B)

Remarque. On voit que l'indépendance n'est pas une qualité intrinsèque des événements, elle dépend de la probabilité considérée.

Exemple. Soit Ω={1,2,3,4,5,6}\Omega = \lbrace 1, 2, 3, 4, 5, 6 \rbrace muni de la tribu P(Ω)\mathcal{P}(\Omega). Soit A={1,2}A = \lbrace 1, 2 \rbrace et B={2,3}B = \lbrace 2, 3 \rbrace 2 événements. Soit P1P_1 et P2P_2 deux probabilités sur (Ω,P(Ω))(\Omega, \mathcal{P}(\Omega)) définies par

ii123456
P1(i)P_1(i)1/61/61/61/61/61/61/61/61/61/61/61/6
P2(i)P_2(i)1/61/61/61/61/31/31/91/91/91/91/91/9

Étudions l'indépendance de AA et BB pour P1P_1 et P2P_2. On a P1(A)=13=P1(B)P_1(A) = \dfrac{1}{3} = P_1(B) ; de plus P1(A∩B)=16≠19P_1(A \cap B) = \dfrac{1}{6} \neq \dfrac{1}{9}, donc AA et BB ne sont pas indépendants pour P1P_1.

On a P2(A)=13P_2(A) = \dfrac{1}{3} et P2(B)=12P_2(B) = \dfrac{1}{2} ; de plus P2(A∩B)=16=P2(A)P2(B)P_2(A \cap B) = \dfrac{1}{6} = P_2(A) P_2(B), donc AA et BB sont indépendants pour P2P_2.

Proposition. Si AA et BB sont indépendants pour la probabilité PP, alors AA et BcB^c, AcA^c et BB, AcA^c et BcB^c sont indépendants pour PP.

Démonstration. P(A∩Bc)+P(A∩B)=P(A)⇔P(A∩Bc)=P(A)−P(A∩B)=P(A)−P(A)P(B)=P(A)(1−P(B))⏟=P(Bc)P(A \cap B^c) + P(A \cap B) = P(A) \Leftrightarrow P(A \cap B^c) = P(A) - P(A \cap B) = P(A) - P(A)P(B) = P(A) \underbrace{(1 - P(B))}_{= P(B^c)}.

Indépendance d'une famille d'événements. Soit II un ensemble (ou une suite d'événements) d'indices fini ou dénombrable. On dit que les événements (Ai)i∈I(A_i)_{i \in I} sont indépendants (ou mutuellement indépendants) si ∀p≥2\forall p \geq 2, ∀i1,…,ip∈I\forall i_1, \dots, i_p \in I (avec ij≠iki_j \neq i_k ∀j≠k\forall j \neq k)

P(Ai1∩⋯∩Aip)=P(Ai1)×⋯×P(Aip)P(A_{i_1} \cap \dots \cap A_{i_p}) = P(A_{i_1}) \times \dots \times P(A_{i_p})

Exemple. Trois événements A,B,CA, B, C sont (mutuellement) indépendants si P(A∩B)=P(A)P(B)P(A \cap B) = P(A)P(B), P(A∩C)=P(A)P(C)P(A \cap C) = P(A)P(C), P(B∩C)=P(B)P(C)P(B \cap C) = P(B)P(C) et

P(A∩B∩C)=P(A)P(B)P(C)P(A \cap B \cap C) = P(A)P(B)P(C)

Définition. On dit que les événements (Ai)i∈I(A_i)_{i \in I} sont 2 à 2 indépendants si ∀i≠j\forall i \neq j, AiA_i et AjA_j sont indépendants.

Exemple fondamental : épreuves répétées. Soit E\mathcal{E} une expérience aléatoire caractérisée par l'espace probabilisé (Ω,F,P)(\Omega, \mathcal{F}, P). On appelle épreuve répétée nn fois l'épreuve (l'expérience aléatoire) En\mathcal{E}^n caractérisée par l'espace probabilisé (Ωn,F⊗n,P⊗n)(\Omega^n, \mathcal{F}^{\otimes n}, P^{\otimes n}) où :

  • Ωn={(ω1,…,ωn),ωi∈Ω,1≤i≤n}\Omega^n = \lbrace (\omega_1, \dots, \omega_n), \omega_i \in \Omega, 1 \leq i \leq n \rbrace ;
  • F⊗n\mathcal{F}^{\otimes n} est la plus petite tribu contenant les ensembles de la forme A1×⋯×AnA_1 \times \dots \times A_n avec Ai∈FA_i \in \mathcal{F}, ∀i\forall i (tribu produit) ;
  • P⊗nP^{\otimes n} est l'unique probabilité sur (Ωn,F⊗n)(\Omega^n, \mathcal{F}^{\otimes n}) telle que ∀A1,…,An∈F\forall A_1, \dots, A_n \in \mathcal{F}
P⊗n(A1×⋯×An)=P(A1)×⋯×P(An)(probabiliteˊ produit)P^{\otimes n}(A_1 \times \dots \times A_n) = P(A_1) \times \dots \times P(A_n) \qquad \text{(probabilité produit)}

Propriété. Soit A~1=A1×Ω×⋯×Ω\tilde{A}_1 = A_1 \times \Omega \times \dots \times \Omega (j'obtiens un résultat dans A1A_1 à la première occurrence),

A~2=Ω×A2×Ω×⋯×Ω  ⋮A~n=Ω×Ω×⋯×Ω×An\begin{aligned} \tilde{A}_2 &= \Omega \times A_2 \times \Omega \times \dots \times \Omega \\ &\ \ \vdots \\ \tilde{A}_n &= \Omega \times \Omega \times \dots \times \Omega \times A_n \end{aligned}

Alors on voit que A~1∩⋯∩A~n=A1×A2×⋯×An\tilde{A}_1 \cap \dots \cap \tilde{A}_n = A_1 \times A_2 \times \dots \times A_n, d'où

P⊗n(A~1∩⋯∩A~n)=P(A1)×⋯×P(An)=P⊗n(A~1)×⋯×P⊗n(A~n)P^{\otimes n}(\tilde{A}_1 \cap \dots \cap \tilde{A}_n) = P(A_1) \times \dots \times P(A_n) = P^{\otimes n}(\tilde{A}_1) \times \dots \times P^{\otimes n}(\tilde{A}_n)

On voit donc que A~1,…,A~n\tilde{A}_1, \dots, \tilde{A}_n sont indépendants pour P⊗nP^{\otimes n}. C'est pourquoi l'indépendance est souvent postulée dans ce cas de figure. Par exemple, si on lance un dé deux fois de suite, les événements relatifs au premier lancer sont indépendants de ceux relatifs au second lancer. Si AA = « le premier lancer est pair » et BB = « le premier lancer donne 6 », on admet que P(A∩B)=P(A).P(B)P(A \cap B) = P(A).P(B).

Définition. Soit (Ω,F,P)(\Omega, \mathcal{F}, P) un espace probabilisé et A∈FA \in \mathcal{F} avec P(A)>0P(A) > 0. On appelle probabilité conditionnelle sachant AA l'application notée PAP_A et définie par

PA:{F→[0,1]B↦PA(B)=P(A∩B)P(A)P_A : \begin{cases} \mathcal{F} \to [0, 1] \\ B \mapsto P_A(B) = \dfrac{P(A \cap B)}{P(A)} \end{cases}

Remarque. On note aussi parfois PA(B)=P(B∣A)P_A(B) = P(B|A).

Remarque.

  1. PAP_A est bien une probabilité :

    PA(Ω)=P(A∩Ω)P(A)=P(A)P(A)=1P_A(\Omega) = \frac{P(A \cap \Omega)}{P(A)} = \frac{P(A)}{P(A)} = 1
  2. Soit (Bn)n≥1(B_n)_{n \geq 1} deux à deux disjoints :

    PA(⋃n=1∞Bn)=P((⋃n=1∞Bn)∩A)P(A)=P(⋃n=1∞(A∩Bn))P(A)=∑n=1∞P(A∩Bn)P(A)=∑n=1∞P(A∩Bn)P(A)=∑n=1∞PA(Bn)\begin{aligned} P_A\left(\bigcup_{n=1}^{\infty} B_n\right) &= \frac{P\left(\left(\bigcup_{n=1}^{\infty} B_n\right) \cap A\right)}{P(A)} \\ &= \frac{P\left(\bigcup_{n=1}^{\infty} (A \cap B_n)\right)}{P(A)} \\ &= \frac{\sum_{n=1}^{\infty} P(A \cap B_n)}{P(A)} \\ &= \sum_{n=1}^{\infty} \frac{P(A \cap B_n)}{P(A)} \\ &= \sum_{n=1}^{\infty} P_A(B_n) \end{aligned}

Proposition. Soit AA et BB deux événements avec P(A)>0P(A) > 0. Alors AA et BB sont indépendants si et seulement si PA(B)=P(B)P_A(B) = P(B).

Démonstration. PA(B)=P(A∩B)P(A)=P(A)P(B)P(A)=P(B)P_A(B) = \dfrac{P(A \cap B)}{P(A)} = \dfrac{P(A)P(B)}{P(A)} = P(B) (si P(B)>0P(B) > 0, AA et BB indépendants ⇔PB(A)=P(A)\Leftrightarrow P_B(A) = P(A)).

Formule des probabilités composées. Soit A1,…,An∈FA_1, \dots, A_n \in \mathcal{F} tels que P(A1∩⋯∩An−1)>0P(A_1 \cap \dots \cap A_{n-1}) > 0. Alors :

  1. P(⋂i=1nAi)=P(A1∩⋯∩An)=P(A1).P(A2∣A1).P(A3∣A1∩A2)×⋯×P(An∣A1∩⋯∩An−1)P\left(\displaystyle\bigcap_{i=1}^{n} A_i\right) = P(A_1 \cap \dots \cap A_n) = P(A_1).P(A_2|A_1).P(A_3|A_1 \cap A_2) \times \dots \times P(A_n|A_1 \cap \dots \cap A_{n-1}).

  2. Si on a une suite d'événements (Ai)i≥1(A_i)_{i \geq 1} avec P(⋂i=1nAi)>0P\left(\displaystyle\bigcap_{i=1}^{n} A_i\right) > 0, ∀n\forall n, alors

    P(⋂i=1∞Ai)=P(A1)×P(A2∣A1)×⋯×P(An∣A1∩⋯∩An−1)×…=∏i=1∞P(Ai∣A1∩⋯∩Ai−1)\begin{aligned} P\left(\bigcap_{i=1}^{\infty} A_i\right) &= P(A_1) \times P(A_2|A_1) \times \dots \times P(A_n|A_1 \cap \dots \cap A_{n-1}) \times \dots \\ &= \prod_{i=1}^{\infty} P(A_i|A_1 \cap \dots \cap A_{i-1}) \end{aligned}

Démonstration. 1) est évident. Pour montrer 2) à partir de 1), on remarque que P(⋂i=1∞Ai)=lim⁡n→+∞P(⋂i=1nAi)P\left(\displaystyle\bigcap_{i=1}^{\infty} A_i\right) = \lim_{n \to +\infty} P\left(\bigcap_{i=1}^{n} A_i\right) (propriété 8.b).

Définition. Soit II fini ou dénombrable. On dit que (Ai)i∈I(A_i)_{i \in I} forme un système complet d'événements si et seulement si les 3 conditions suivantes sont vérifiées :

  • ∀i∈I\forall i \in I, Ai≠∅A_i \neq \emptyset ;
  • ∀i≠j\forall i \neq j, Ai∩Aj=∅A_i \cap A_j = \emptyset ;
  • ⋃i∈IAi=Ω\displaystyle\bigcup_{i \in I} A_i = \Omega.

On dit que (Ai)i∈I(A_i)_{i \in I} forme une partition de Ω\Omega.

Théorème I.6. (Formule des probabilités totales) Soit (Ai)i∈I(A_i)_{i \in I} un système complet d'événements d'un espace probabilisé (Ω,F,P)(\Omega, \mathcal{F}, P) tel que ∀i∈I\forall i \in I, P(Ai)>0P(A_i) > 0, et soit E∈FE \in \mathcal{F} un événement quelconque. Alors

P(E)=∑i∈IP(E∣Ai)P(Ai)=∑i∈IPAi(E)P(Ai)P(E) = \sum_{i \in I} P(E|A_i)P(A_i) = \sum_{i \in I} P_{A_i}(E)P(A_i)

Démonstration.

P(E)=P(Ω∩E)=P((⋃iAi)∩E)=P(⋃i(Ai∩E))=∑iP(Ai∩E)=∑iP(E∣Ai).P(Ai)\begin{aligned} P(E) &= P(\Omega \cap E) \\ &= P\left(\left(\bigcup_i A_i\right) \cap E\right) \\ &= P\left(\bigcup_i (A_i \cap E)\right) \\ &= \sum_i P(A_i \cap E) \\ &= \sum_i P(E|A_i).P(A_i) \end{aligned}

Remarque. La formule reste vraie si on suppose que P(⋃i∈IAi)=1P\left(\bigcup_{i \in I} A_i\right) = 1 (sans nécessairement avoir ⋃i∈IAi=Ω\bigcup_{i \in I} A_i = \Omega). En effet, P(E)=P((⋃Ai)∩E)+P((⋃Ai)c∩E)P(E) = P\left(\left(\bigcup A_i\right) \cap E\right) + P\left(\left(\bigcup A_i\right)^c \cap E\right), or P((⋃Ai)c)=1−P(⋃Ai)=0⇒P((⋃Ai)c∩E)=0P\left(\left(\bigcup A_i\right)^c\right) = 1 - P\left(\bigcup A_i\right) = 0 \Rightarrow P\left(\left(\bigcup A_i\right)^c \cap E\right) = 0.

Corollaire 5.1. (Formule de Bayes) Soit (Ai)i∈I(A_i)_{i \in I} un système complet d'événements d'un espace probabilisé (Ω,F,P)(\Omega, \mathcal{F}, P) tel que P(Ai)>0P(A_i) > 0, ∀i\forall i. Soit E∈FE \in \mathcal{F} avec P(E)>0P(E) > 0, alors ∀i∈I\forall i \in I,

PE(Ai)=P(Ai∣E)=P(Ai∩E)P(E)=P(E∣Ai).P(Ai)∑j∈IP(E∣Aj)P(Aj)P_E(A_i) = P(A_i|E) = \frac{P(A_i \cap E)}{P(E)} = \frac{P(E|A_i).P(A_i)}{\sum_{j \in I} P(E|A_j)P(A_j)}

Indépendance conditionnelle. Soit EE un événement avec P(E)>0P(E) > 0. On dit que 2 événements AA et BB sont indépendants conditionnellement à EE (pour la probabilité PP) si AA et BB sont indépendants pour la probabilité conditionnelle PEP_E, c'est-à-dire si PE(A∩B)=PE(A).PE(B)⇔P(A∩B∣E)=P(A∣E).P(B∣E)P_E(A \cap B) = P_E(A).P_E(B) \Leftrightarrow P(A \cap B|E) = P(A|E).P(B|E).

Exemple. On dispose de deux pièces, une équilibrée et une telle que P(face)=34P(\text{face}) = \dfrac{3}{4}. On sélectionne une des 2 pièces au hasard et on la lance 2 fois. Soit FiF_i l'événement « on obtient face au lancer ii » où i=1,2i = 1, 2. Soit PiP_i l'événement « on a sélectionné la pièce ii » où i=1,2i = 1, 2. Alors F1F_1 et F2F_2 sont indépendants conditionnellement à P1P_1 ou P2P_2.

P(F1∩F2∣P1)=P(F1∣P1).P(F2∣P1)=14P(F_1 \cap F_2|P_1) = P(F_1|P_1).P(F_2|P_1) = \frac{1}{4}
P(F1∩F2∣P2)=P(F1∣P2).P(F2∣P2)=916P(F_1 \cap F_2|P_2) = P(F_1|P_2).P(F_2|P_2) = \frac{9}{16}

Est-ce que F1F_1 et F2F_2 sont indépendants (pour la probabilité PP) ?

P(F1∩F2)=?P(F1)P(F2)P(F_1 \cap F_2) \overset{?}{=} P(F_1)P(F_2)

P(F1)=P(F1∣P1).P(P1)+P(F1∣P2)P(P2)=12⋅12+34⋅12=58=P(F2)P(F_1) = P(F_1|P_1).P(P_1) + P(F_1|P_2)P(P_2) = \frac{1}{2} \cdot \frac{1}{2} + \frac{3}{4} \cdot \frac{1}{2} = \frac{5}{8} = P(F_2)

P(F1∩F2)=P(F1∩F2∣P1)×P(P1)+P(F1∩F2∣P2).P(P2)=14⋅12+916⋅12=1332≠(58)2=P(F1)×P(F2)P(F_1 \cap F_2) = P(F_1 \cap F_2|P_1) \times P(P_1) + P(F_1 \cap F_2|P_2).P(P_2) = \frac{1}{4} \cdot \frac{1}{2} + \frac{9}{16} \cdot \frac{1}{2} = \frac{13}{32} \neq \left(\frac{5}{8}\right)^2 = P(F_1) \times P(F_2)

Donc F1F_1 et F2F_2 ne sont pas indépendants pour la probabilité PP.

P(P2∣F1)=P(F1∣P2).P(P2)P(F1∣P1)P(P1)+P(F1∣P2)P(P2)=34×1212×12+12×34=3412+34\begin{aligned} P(P_2|F_1) &= \frac{P(F_1|P_2).P(P_2)}{P(F_1|P_1)P(P_1) + P(F_1|P_2)P(P_2)} \\ &= \frac{\frac{3}{4} \times \frac{1}{2}}{\frac{1}{2} \times \frac{1}{2} + \frac{1}{2} \times \frac{3}{4}} \\ &= \frac{\frac{3}{4}}{\frac{1}{2} + \frac{3}{4}} \end{aligned}
P(P2∣F1∩F2)=9/16×1/21/4×1/2+9/16×1/2=9/13P(P_2|F_1 \cap F_2) = \frac{9/16 \times 1/2}{1/4 \times 1/2 + 9/16 \times 1/2} = 9/13