Body Analysis
Contexte
Samsung Health exporte des CSV et fichiers d'activité bruts, sans aucune visualisation exploitable. Passer par une application tierce aurait signifié confier des données de santé (poids, composition corporelle, fréquence cardiaque, photos de suivi) à un service externe. J'ai construit la chaîne moi-même (ingestion, modélisation, analytics, interface), déployée sur mon infrastructure personnelle et alimentée en continu depuis 2023.
Le projet a été réécrit en 2026 : la version initiale était une application Streamlit monolithique ; la version actuelle sépare une API FastAPI et une SPA React, avec une persistance PostgreSQL et un stockage objet S3 pour les photos.
Aperçu
Les captures ci-dessous ont été réalisées sur une instance locale alimentée par un export Samsung Health fictif de quatre mois, importé par la même chaîne d'ingestion que les données réelles.
- Aujourd'hui
- Entraînement
- Natation
- Récupération
- Composition corporelle
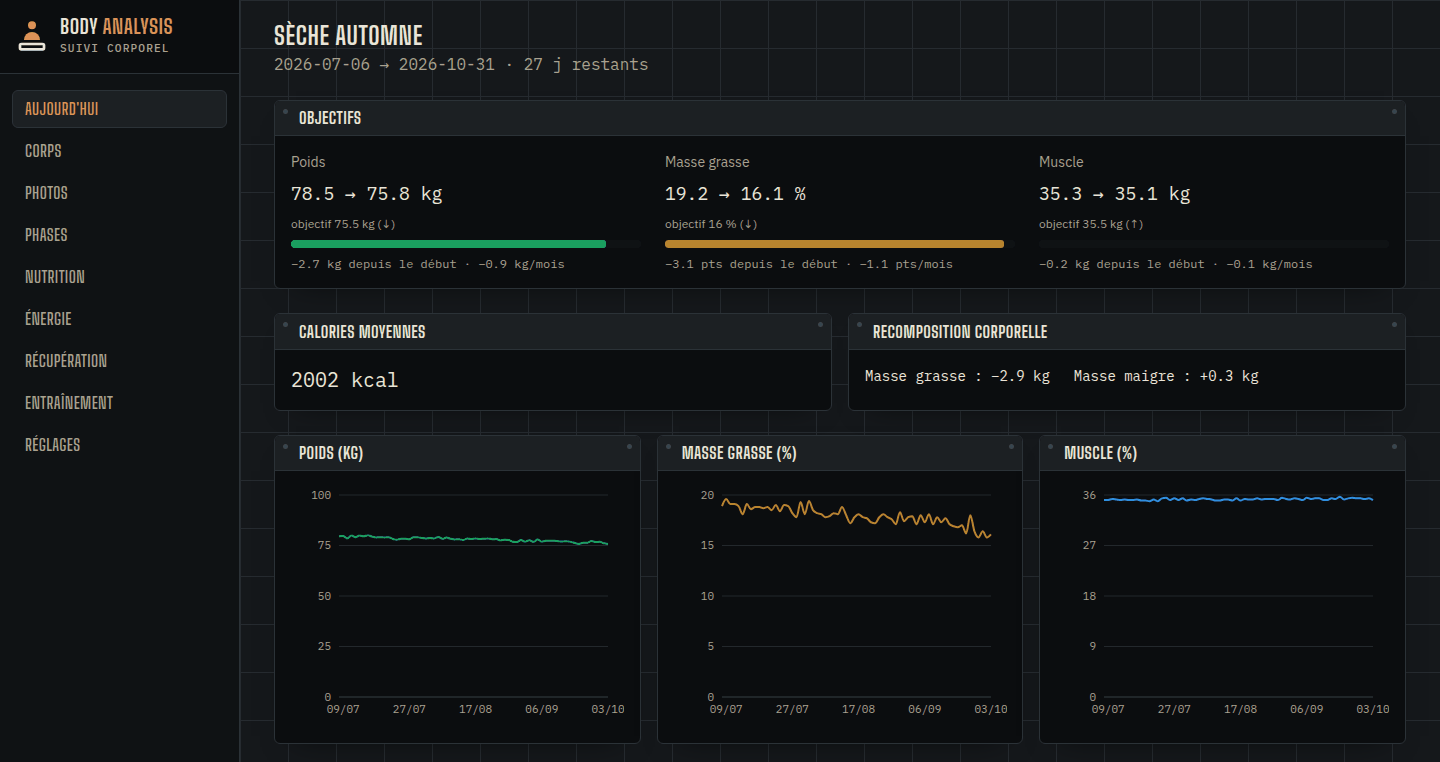
Vue d'ensemble de la phase en cours : progression vers chaque objectif, calories moyennes et recomposition (masse grasse contre masse maigre).
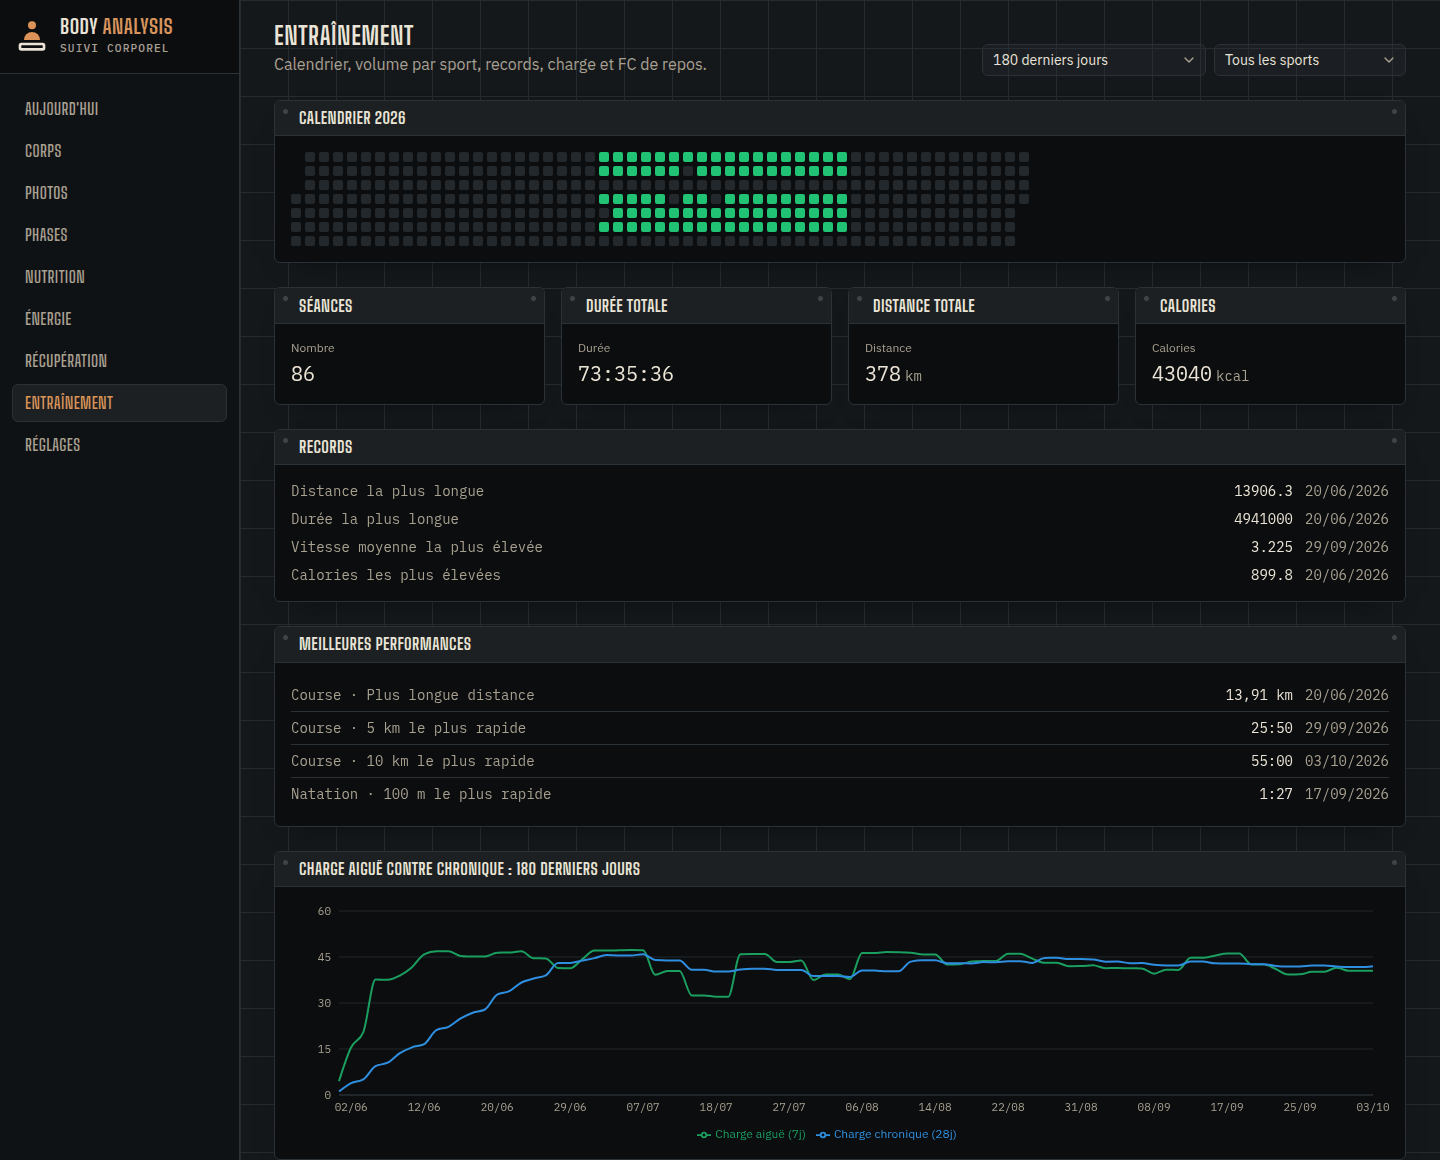
Calendrier, totaux, records personnels et charge d'entraînement : TRIMP cumulé sur 7 jours (charge aiguë) et sur 28 jours (charge chronique).
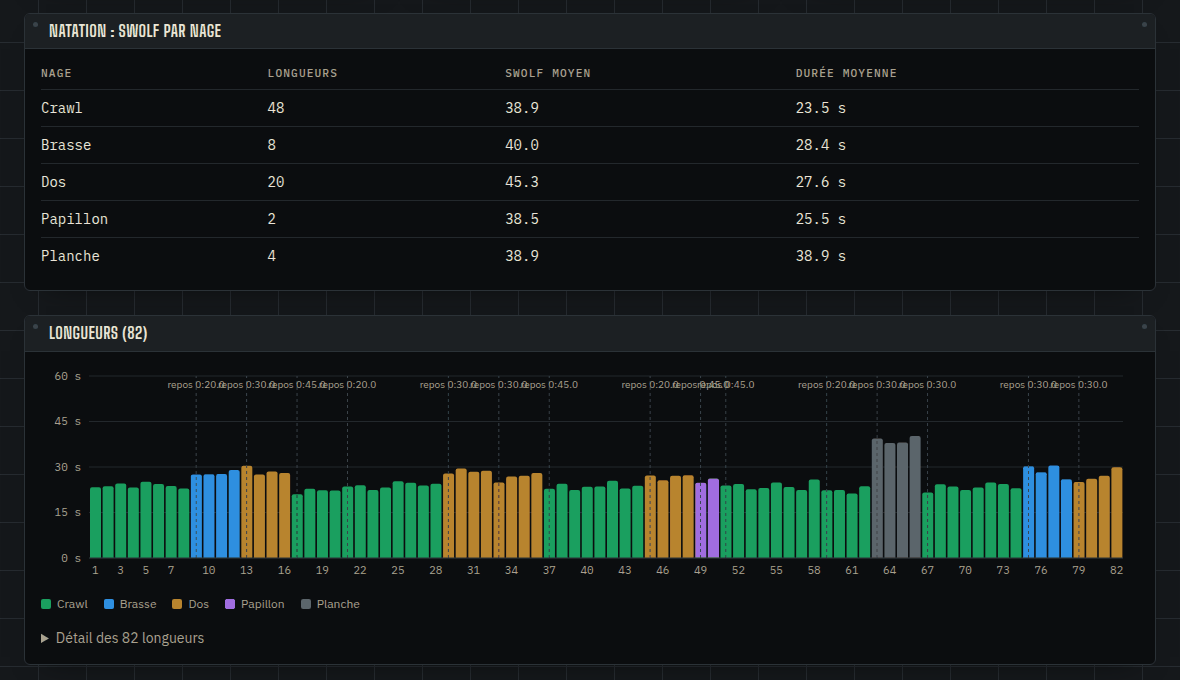
Détail d'une séance de natation : SWOLF moyen par nage, puis chaque longueur restituée avec sa durée, sa nage et les repos entre les séries.
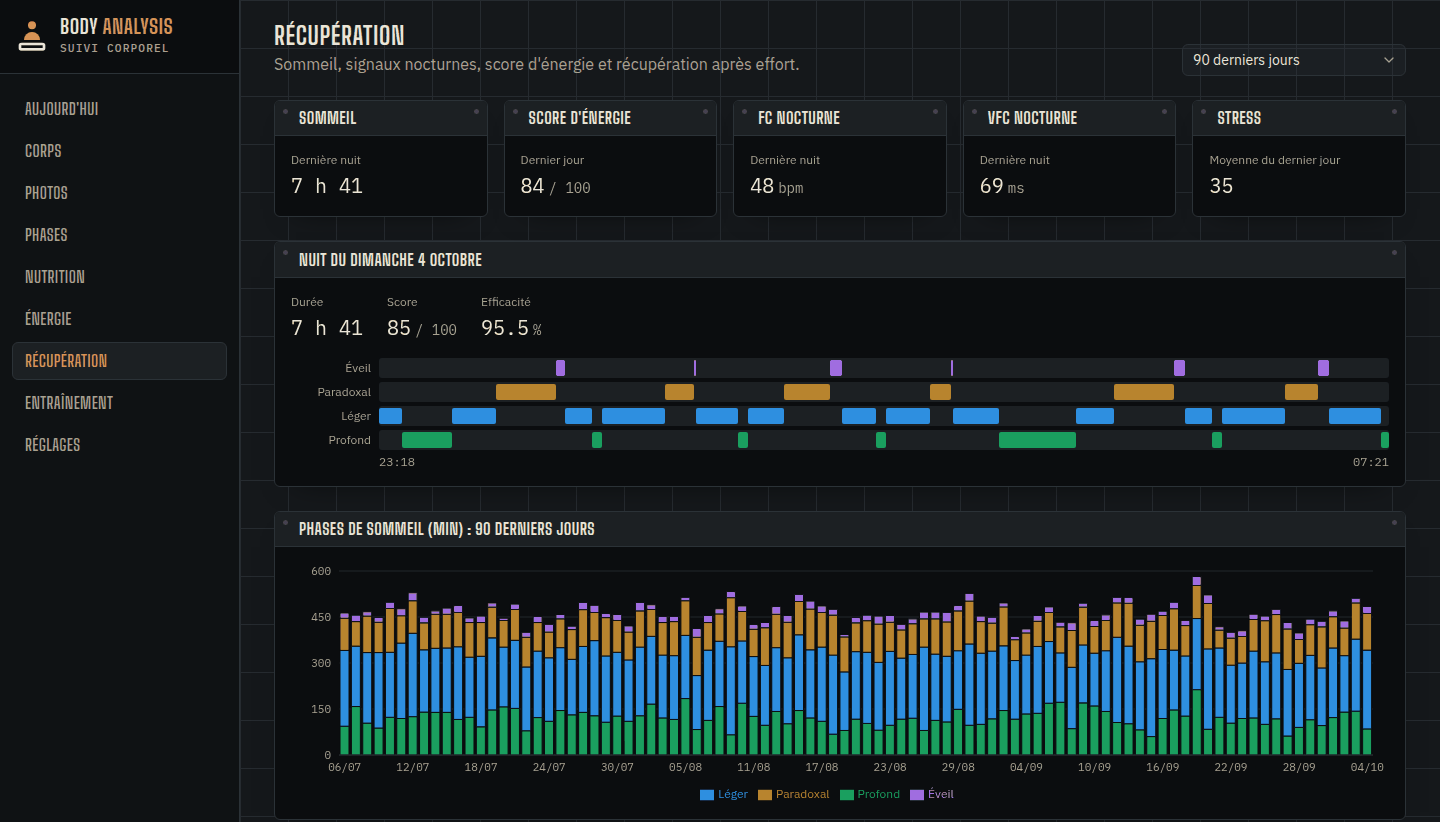
Signaux nocturnes de la dernière nuit (FC, VFC, score d'énergie), hypnogramme et répartition des phases de sommeil sur 90 jours.
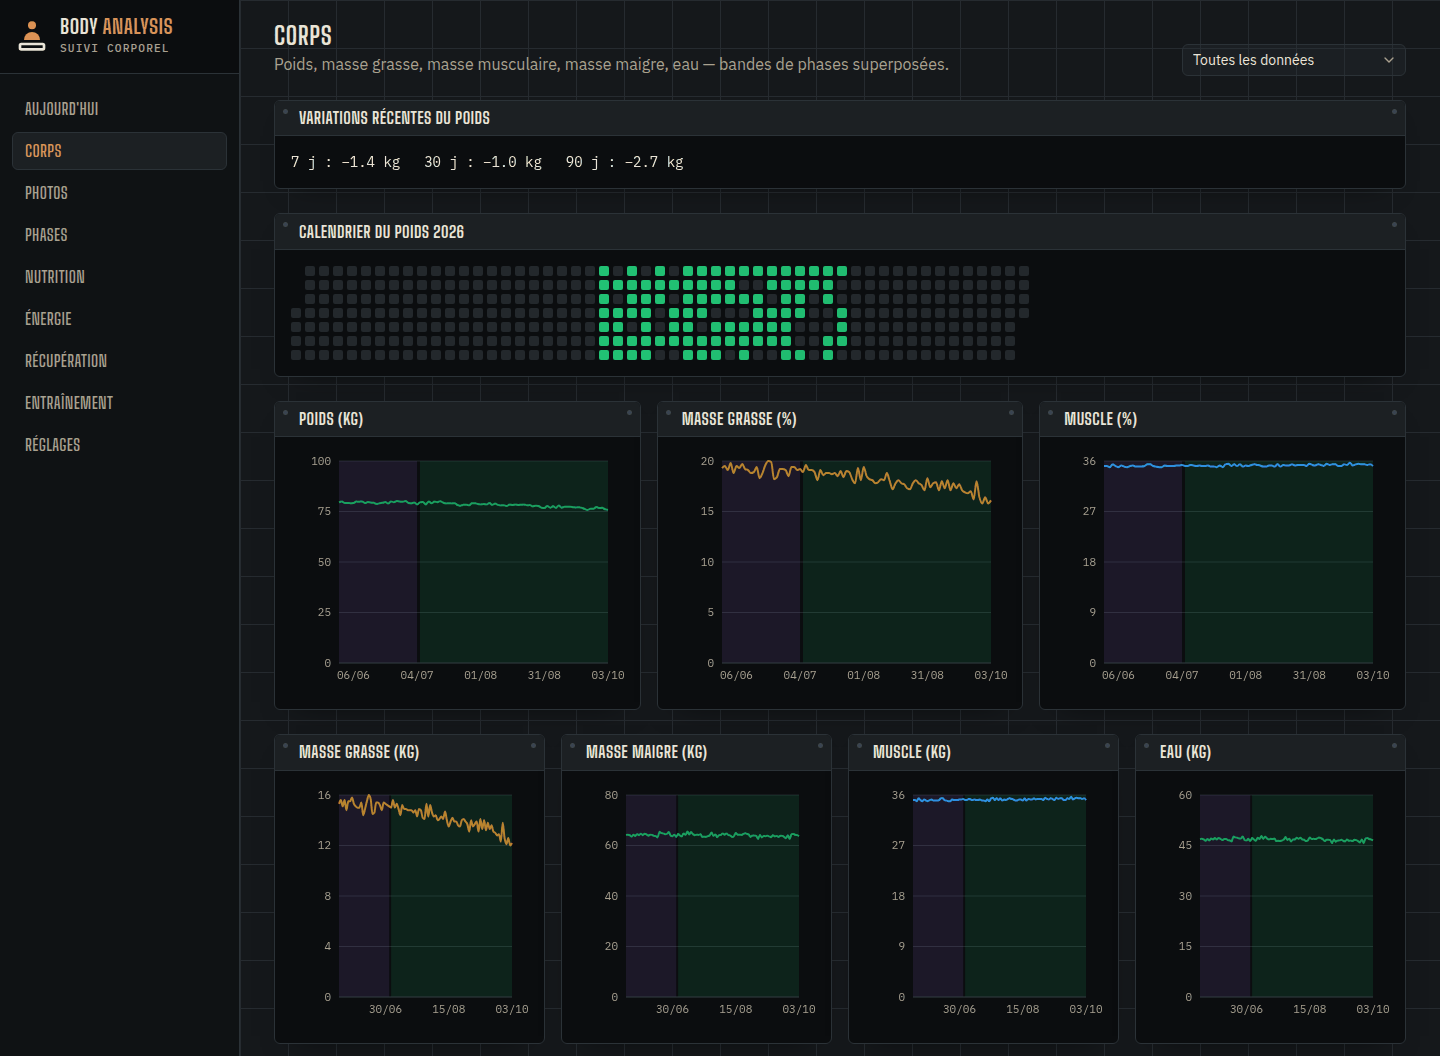
Poids, masse grasse, masse musculaire, masse maigre et eau, avec les phases (maintien puis sèche) superposées en bandes de couleur.
Stack technique
Architecture
L'export ZIP est envoyé depuis le navigateur, ingéré en tâche de fond par l'API, puis restitué par le module d'analytics à la SPA. Depuis octobre 2026, une appli Android envoie aussi les nouvelles mesures deux fois par jour.
Ingestion des exports Samsung Health
L'export Samsung Health est une archive ZIP volumineuse (1,3 Go décompressés pour l'export réel de ce projet, environ 88 000 fichiers) et non fiable par construction : c'est une entrée utilisateur, pas un format contrôlé. L'extraction vérifie donc les chemins de chaque entrée avant d'écrire le moindre octet, pour bloquer une évasion de répertoire (zip-slip), et suit le volume décompressé en continu pendant l'écriture plutôt que de se fier à la taille déclarée dans les métadonnées de l'archive, qu'un fichier malveillant contrôle entièrement. Le nombre d'entrées est également plafonné, pour se prémunir d'une bombe de décompression.
Les CSV eux-mêmes varient selon la version de l'application source : champs absents, dates mal formées, types numériques instables. Chaque module d'ingestion valide et normalise sa source avant de la faire entrer dans le modèle relationnel, plutôt que de laisser une exception de parsing interrompre silencieusement le traitement d'une ligne.
Le format réel de l'export s'est révélé différent de celui des fixtures de test sur plusieurs points, sans qu'aucune erreur ne le signale. Une archive zippée depuis le téléphone place tout son contenu sous un dossier racine horodaté : l'import ne trouvait aucun fichier reconnu et se terminait en succès avec zéro ligne. Il descend désormais dans ce dossier, et un import sans aucune source reconnue est marqué en échec plutôt qu'en succès vide. De même, des colonnes préfixées dans les CSV de fréquence cardiaque et de SpO₂, un fichier d'histogramme lu à la place du stress et des JSON de variabilité cardiaque cherchés hors de leur sous-dossier faisaient perdre ces signaux en entier. Les fixtures reprennent maintenant la structure exacte d'un export réel, pour que les tests échouent sur ce type d'écart.
Synchronisation depuis le téléphone
L'export ZIP demande une manipulation sur le téléphone à chaque mise à jour. En octobre 2026, j'ai développé une appli Android (Kotlin, Jetpack Compose) qui lit Samsung Health par le Samsung Health Data SDK et envoie les nouvelles mesures à l'API deux fois par jour, plus à la demande, par une route d'ingestion dédiée protégée par jeton. La planification passe par WorkManager, qui laisse Android décaler l'exécution selon l'état de la batterie et du réseau.
Pour ne perdre aucune mesure sans tout renvoyer à chaque passage, l'appli lit l'API de changements du SDK, qui liste les mesures modifiées depuis un instant donné, avec un curseur par type de donnée. Un curseur n'avance que lorsque tous les lots contenant son type ont été acceptés par le serveur : une coupure réseau ou une panne de l'API, quelle que soit sa durée, est rattrapée à la synchronisation suivante, et un échec durable déclenche une alerte locale sur le téléphone. Chaque lecture recouvre les deux jours précédant le curseur, et l'API rend l'ingestion idempotente en reprenant les identifiants de l'export ZIP : une mesure reçue deux fois, ou déjà importée par une archive, n'est pas dupliquée. La première synchronisation se limite ainsi à trois jours, l'historique étant déjà en base.
Comme les fixtures avant eux, les premiers lots réels ont fait apparaître des écarts : les horodatages de l'export ZIP étaient à lire en UTC, et la première version du contrat ignorait les routines, le score d'énergie et les heures à la seconde. Des tests vérifient maintenant qu'une même mesure donne la même ligne par les deux chemins d'ingestion.
L'application expose aussi un serveur MCP, protégé par jeton, qui permet à un assistant IA d'interroger les données. Son flux SSE traverse le nginx du frontend avec la mise en tampon désactivée, pour que les événements arrivent au fil de l'eau.
Récupération et sommeil
Une page Récupération rassemble les signaux nocturnes et de repos que l'ingestion ignorait jusque-là : hypnogramme et phases de sommeil, fréquence cardiaque, SpO₂ et ronflement nocturnes, variabilité cardiaque, score d'énergie, fréquence cardiaque de récupération après effort. Chaque séance est aussi replacée dans son contexte (météo notamment) et comparée aux meilleures performances enregistrées.
Analytics d'entraînement
Le module analytics/ du backend est délibérément isolé de la base de données et du framework web : chaque fonction prend des structures de données en entrée et retourne des structures en sortie, ce qui les rend testables sans infrastructure. Il couvre plusieurs métriques issues de la physiologie de l'effort :
- TRIMP (Training Impulse) : charge d'un entraînement calculée par intégration de la réserve de fréquence cardiaque sur la durée de la séance, pondérée par une fonction exponentielle qui accorde plus de poids aux efforts proches du maximum.
- Charge aiguë/chronique (ACWR) : rapport entre la charge d'entraînement moyenne sur 7 jours et sur 28 jours, indicateur de risque de blessure par sur-sollicitation quand ce ratio s'éloigne trop de 1.
- Dérive cardiaque : écart de fréquence cardiaque moyenne entre la première et la seconde moitié d'une séance à effort comparable, signe de fatigue ou de perte d'économie de course.
- Zones de fréquence cardiaque : répartition du temps d'entraînement par zone (récupération à maximal), calculée à partir des échantillons de fréquence cardiaque et de la fréquence maximale de l'utilisateur.
D'autres modules du même dossier couvrent la composition corporelle, la nutrition, les records personnels et les phases (bulk, cut, maintien), chacun avec sa propre logique de calcul mais la même contrainte d'isolation. La VO₂max estimée par la montre est suivie dans le temps.
Le détail de séance dépend du sport. Samsung Health enregistre chaque exercice d'une routine de musculation comme une séance distincte : une heure de salle apparaissait comme une dizaine de séances, ce qui faussait le calendrier et les statistiques. Les routines sont désormais ingérées et chaque exercice rattaché à la sienne ; une routine compte pour une séance, et sa page détaille échauffement, exercices, séries et volume. Pour la natation, chaque longueur est restituée (durée, nage, nombre de mouvements, SWOLF, repos) sous forme de barres colorées par nage. Pour la course, le bloc principal est isolé de l'échauffement et du retour au calme.
Photos et confidentialité
Les photos de suivi corporel sont par nature privées. Elles sont stockées dans un stockage objet S3 plutôt que sur le système de fichiers de l'application, à travers un client dédié qui centralise tous les appels au SDK S3 : le reste du backend ne connaît jamais le stockage directement, ce qui permet de le substituer par un double de test dans la suite unitaire. Ce découplage a servi en octobre 2026 : l'image MinIO ayant été retirée de Docker Hub, la production est passée sur une instance Garage dédiée sans aucune modification du code de l'API.
Le traitement d'image ne fait confiance ni à l'extension du fichier envoyé ni au Content-Type déclaré par le client : le type réel est déterminé en inspectant les premiers octets du fichier. L'orientation est corrigée à partir du tag EXIF plutôt que d'une heuristique sur les dimensions de l'image, ce qui corrige un bug de l'ancienne version qui retournait à tort toute photo réellement prise en format paysage. En mode confidentiel, chaque photo est floutée par filtre gaussien à la volée, sans jamais mettre en cache le rendu flouté : l'original stocké reste la seule version durable.
Déploiement
L'application se compose de quatre services orchestrés par Docker Compose : PostgreSQL, le stockage objet (MinIO en développement, Garage en production), l'API FastAPI et le frontend, complétés par une seconde instance PostgreSQL dédiée aux tests d'intégration, pour que la suite de tests ne touche jamais aux données réelles. Le frontend a deux profils distincts : un service de développement (Node + Vite, rechargement à chaud) actif par défaut, et une image de production (build statique servi par nginx, sans runtime Node) qui ne démarre que sur demande explicite via un profil Compose, pour valider l'image avant bascule sans interrompre l'environnement de développement.
Le conteneur de l'API applique les migrations Alembic à son démarrage, avant de lancer le serveur. Ce n'était pas le cas au départ : une nouvelle image déployée sur une base restée à l'ancien schéma échouait sur ses nouvelles tables. Lier la migration au démarrage garantit que le schéma suit toujours la version du code déployée.
Le workflow GitHub Actions construit et publie les deux images (API et frontend) sur GitHub Container Registry à chaque push sur master, chacune taguée à la fois latest et par SHA de commit. Le build tourne depuis octobre 2026 sur le runner auto-hébergé de mon homelab, sans consommer les minutes GitHub Actions du dépôt privé. En production, l'application tourne sur mon homelab : utilisée quelques minutes par semaine, elle est arrêtée par Sablier après 30 minutes d'inactivité et redémarrée à la première requête, ce qui libère la mémoire occupée au repos par ses conteneurs.
L'interface suit la charte graphique commune aux applications de mon homelab : thème sombre, un seul accent de couleur, nom de l'application en deux tons, libellés en français.
Tests
La suite de tests backend compte 58 fichiers et près de 350 fonctions de test, réparties entre tests unitaires (calcul des métriques d'analytics, traitement d'image, sécurité de l'extraction ZIP) et tests d'intégration sur les services exposés par l'API. Le frontend dispose de sa propre suite Vitest.
Résultats
- Données de santé gardées sur mon infrastructure : les exports Samsung Health sont ingérés et analysés sans passer par un service tiers, photos de suivi comprises.
- Ingestion d'un export réel de 1,3 Go (environ 88 000 fichiers) par une extraction protégée contre l'évasion de répertoire et les bombes de décompression.
- Pertes de données silencieuses supprimées : les écarts entre l'export réel et les fixtures (dossier racine horodaté, colonnes préfixées, fichiers mal identifiés) sont corrigés et couverts par des fixtures conformes, et un import sans source reconnue échoue au lieu de réussir à vide.
- Données à jour sans manipulation : l'appli Android synchronise les mesures deux fois par jour, sans perte en cas de coupure et sans doublon avec les imports ZIP.
- Signaux auparavant ignorés exploités : sommeil, récupération, routines de musculation regroupées en une séance, détail longueur par longueur de la natation.
- Déploiement sans intervention manuelle : images publiées par la CI à chaque push, migrations appliquées au démarrage de l'API, conteneurs arrêtés au repos grâce à la mise en veille.
Liens
- HomeLab : infrastructure qui héberge l'application
Le dépôt est privé.
Articles liés
5 articles du blog détaillent des notions mises en pratique dans ce projet.
- Traefik : Sablier
Application utilisée quelques minutes par semaine, arrêtée après 30 minutes d'inactivité et redémarrée à la première requête, ce qui libère la mémoire occupée au repos par ses conteneurs.
- Python : uv
Gestion des dépendances Python du backend FastAPI de l'application (SQLAlchemy, Pydantic, Alembic) avec uv.
- Python : async/await
Backend FastAPI dont l'accès à la base de données passe par SQLAlchemy en mode asynchrone.
- Docker : bonnes pratiques
Image de production du frontend réduite à un build statique servi par nginx, sans runtime Node, publiée avec l'image de l'API sur GitHub Container Registry et taguée par SHA de commit.
- GitHub Container Registry (GHCR)
Images de l'API et du frontend publiées sur GHCR à chaque push sur
master, taguées à la foislatestet par SHA de commit.